同一段錄音,少等了將近 40 秒
Day 273 分享的 hidock-hub,是我自己架的錄音整理工具:HiDock P1 錄音筆插上電腦,錄音就自動傳到 MacBook Pro,轉成逐字稿,再整理進我的知識庫。
這幾天我在 MacBook Air 上跟 Claude Code(會自己讀程式、改程式的 AI 助理)一起調它的速度。一段 11.1 分鐘的錄音,語音辨識的時間從 105.8 秒降到 66.9 秒,少等了將近 40 秒,逐字稿的內容幾乎沒變。
省下來的時間,最大的一塊來自它原本一直在重複做同一件事。
這篇分享:它重複做了什麼、另一塊時間怎麼省下來,以及那 1.7% 不一樣的字,我自己聽過之後,發現是哪一版比較對。
轉逐字稿分成「聽」和「寫」兩段
hidock-hub 用的是 Breeze-ASR-25(聯發科以 Whisper 為基礎、針對台灣中文調過的語音辨識模型)。它每次取一段 30 秒的聲音來處理,每一段都要經過兩個步驟:
- 聽:先把這 30 秒的聲音整理成模型看得懂的特徵
- 寫:再根據這些特徵,一個字一個字把逐字稿寫出來
這兩段慢的原因不一樣,所以後面兩個改法,剛好一段處理一個。
同一段聲音,它聽了好幾次
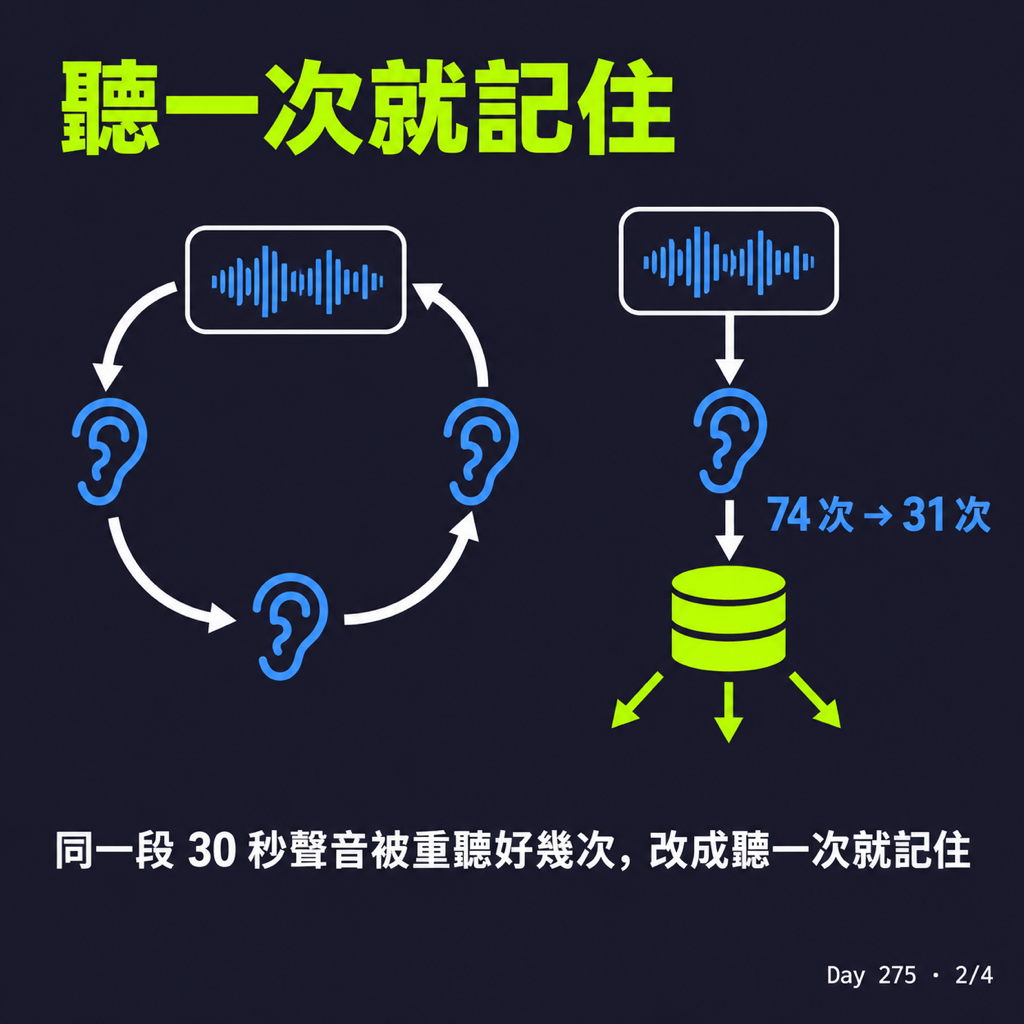
Claude Code 去翻了 hidock-hub 底下用的套件(別人寫好、拿來直接用的現成程式),發現同一段 30 秒的聲音,會被重新「聽」好幾次:
- 第一次是為了寫出文字
- 第二次是為了標出每個字在錄音裡的時間點
- 寫出來的結果如果沒通過品質檢查,它會換個方式重寫,每重寫一次就再聽一次
同一段聲音,不管聽幾次,聽出來的特徵都一樣。所以改法很直接:聽一次就記住,後面要用直接拿出來。
只做這一步,11.1 分鐘的錄音,「聽」的次數從 74 次降到 31 次,時間從 105.8 秒降到 82.8 秒。逐字稿跟原本一字不差,連每個字的時間點都一樣。
負責「寫」的那一半,存成精簡版
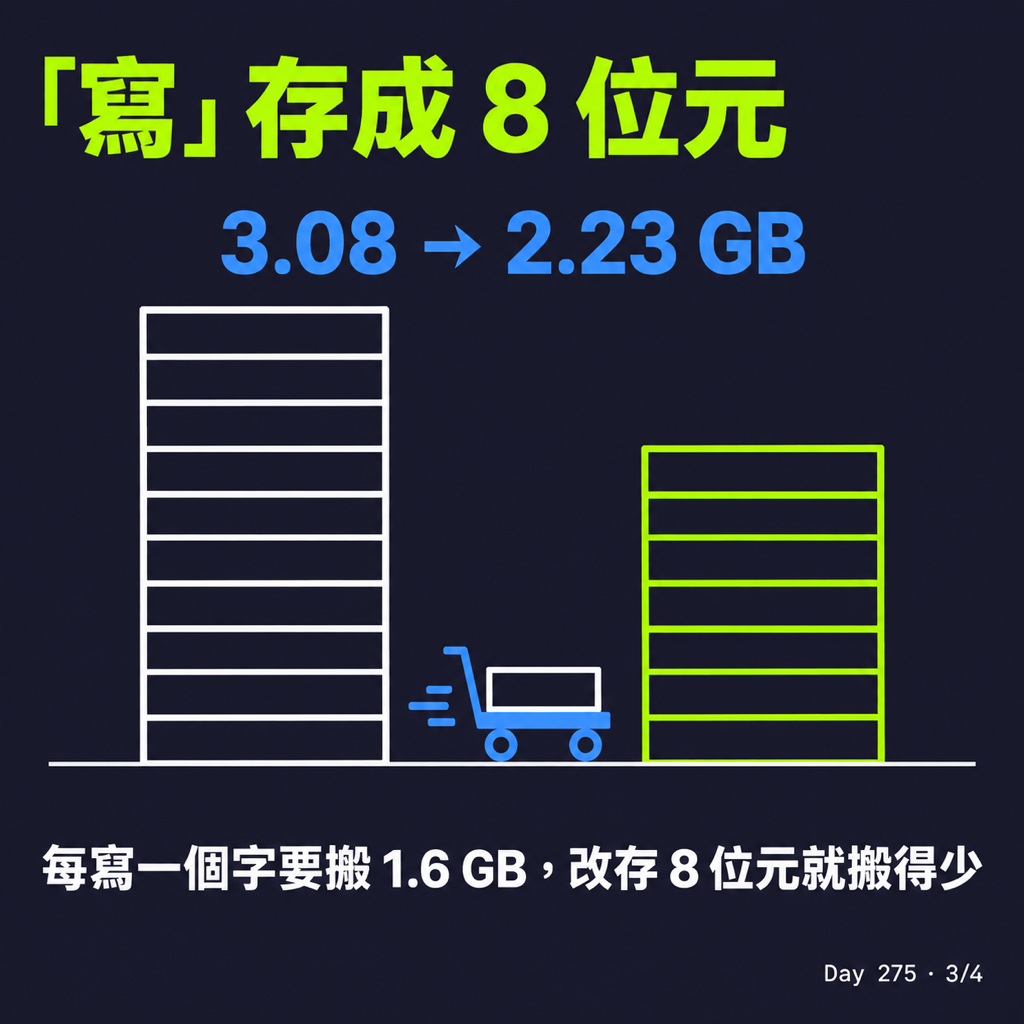
「寫」那一段慢在另一個地方。它每寫出一個字(或一個詞),都要把負責「寫」的那一半模型整個讀過一遍,大約 1.6 GB。所以它的速度卡在搬資料,跟算得快不快關係不大。
第二步就是把這一半存得精簡一點。模型裡全是數字,原本每個數字用 16 位元存,改成 8 位元,有點像把小數點後面多留的幾位四捨五入掉。資料變小,每寫一個字要搬的東西就少了。
「聽」的那一半維持原樣。它慢在要算的東西多,存小一點幫助不大。
結果模型檔從 3.08 GB 變成 2.23 GB,跑起來最多佔用的記憶體從 3.7 GB 降到 2.9 GB。只做這一步,時間從 105.8 秒降到 90.5 秒。
怎麼確認它沒有變笨
要比得準,同一段錄音每次轉出來的字得先固定下來。
Breeze 遇到沒把握的段落,會隨機換個寫法再寫一次。所以同一個版本跑兩次,逐字稿就有 0.4% 的字不一樣,時間也會差幾秒——原版跑兩次,分別是 103.9 秒和 106.2 秒。
所以最後的比較,都固定了隨機種子(讓亂數每次都照同一個順序出來的起始值),讓每一次都抽到一樣的結果。這樣比出來的差別,才是改法本身造成的。
固定之後:
- 只做第一步:逐字稿跟原版一字不差
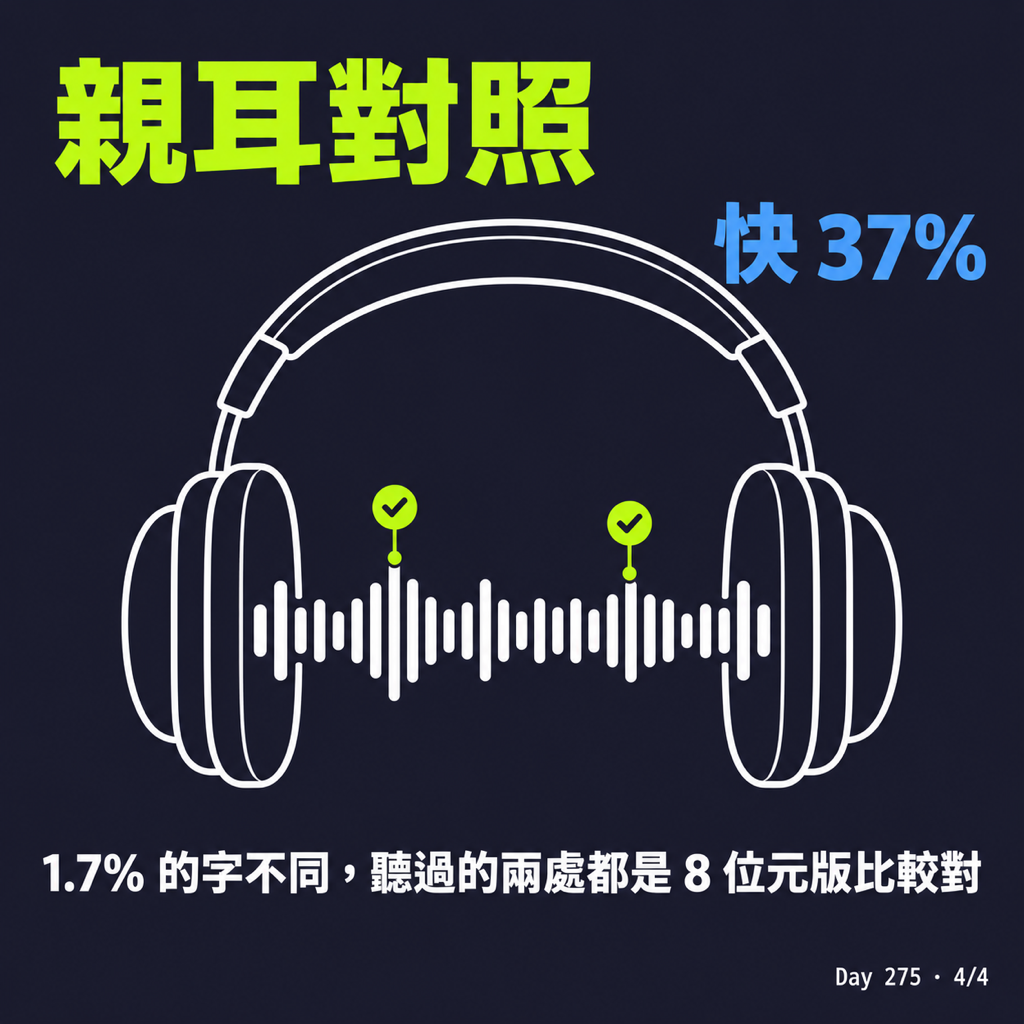
- 有做第二步:跟原版比,有 1.7% 的字不一樣
那 1.7% 差在哪裡
Claude Code 把不一樣的地方挑出來,做成一頁可以邊聽錄音邊對照的網頁。11 分鐘裡一共四處:
- 05:48:原版聽成「代謝」,8 位元版聽成「帶出來」
- 09:05:一整句兩邊寫得不一樣
- 09:40:原版寫出一串字,但它自己的把握只有 8%,8 位元版直接略過那一串
- 10:05:一句英文,兩個版本都寫成亂碼
第 3、4 處本來就是模型聽不清楚的地方,原版自己跑兩次也會不一樣。真正要靠耳朵判斷的,只有前兩處。
這段錄音沒有人工校對過的標準答案,光看數字,只能說 8 位元版跟原版「不一樣」。
所以我自己把這兩處聽了一遍。05:48 講的是「帶出來」,09:05 那一整句也是 8 位元版寫得比較貼近原話。聽過的兩處,都是 8 位元版比較對。
兩步都做,快了 37%
| 版本 | 語音辨識時間 | 「聽」的次數 | 最多佔用記憶體 | 逐字稿跟原版比 |
|---|---|---|---|---|
| 原版 | 105.8 秒 | 74 | 3.7 GB | — |
| 只做第一步:聽一次就記住 | 82.8 秒(−22%) | 31 | 3.7 GB | 一字不差 |
| 只做第二步:「寫」存成 8 位元 | 90.5 秒(−14%) | 75 | 2.9 GB | 1.7% 的字不同 |
| 兩步都做 | 66.9 秒(−37%) | 32 | 2.9 GB | 1.7% 的字不同 |
測試用的是跑 hidock-hub 的 MacBook Pro(M1 Pro),電腦裡負責大量運算的晶片(GPU)全部給它用,固定隨機種子。換算下來,原本每 1 分鐘錄音要花大約 9.5 秒辨識,現在大約 6 秒。
省下最多、也最安全的那一段時間,原本都花在重聽同一段聲音。
Day 273 錄音筆插上電腦就自動進知識庫:https://www.dawsonwang.com/day/273 Breeze-ASR-25:https://huggingface.co/MediaTek-Research/Breeze-ASR-25