Day 278
Jev 大限已到
Day 264 寫完 Jev 沒多久,OpenAI 在 DevDay 2026 推出了 Decisions API。
Jev 的觀點很獨到:把「挑一個」從大型語言模型裡獨立出來,做成專門的決策模型。但它最有價值的核心概念,正逐漸被各平台採用。
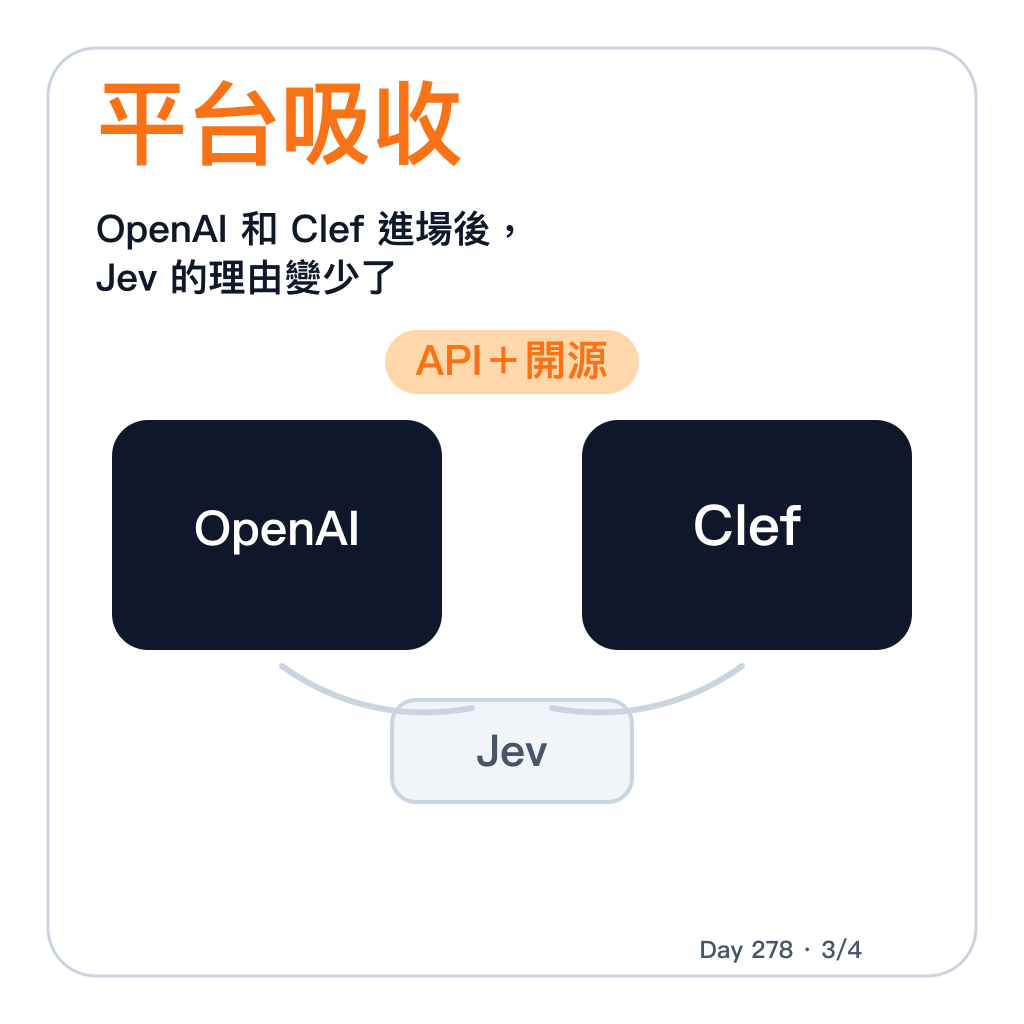
但在 OpenAI、Cloudflare 和可自行部署的模型一起進場後,現在已經很難找到一定要用 Jev 的理由。
尤其 OpenAI 的 Decisions API 還能把圖片當上下文;只要整合得夠好,省錢、快速這些優勢就能由平台內建提供,不需要大家自己另外接 Jev。
它做的事很眼熟:人先定好幾個答案,再給模型文字或圖片當上下文,請它挑一個。Cloudflare 也在 Hugging Face 放出 Clef,一個專門做「答案固定的選擇題」的多模態模型,也就是可以一起看文字和圖片的決策模型。
Jev 沒關掉,TypeSafe 的狀態頁和 API 文件都還活著。
這篇分享:OpenAI Decisions API 跟 Jev 像在哪、Cloudflare Clef 補上哪一塊,以及我現在會怎麼看這類「決策模型」。
Jev 的理由變少了
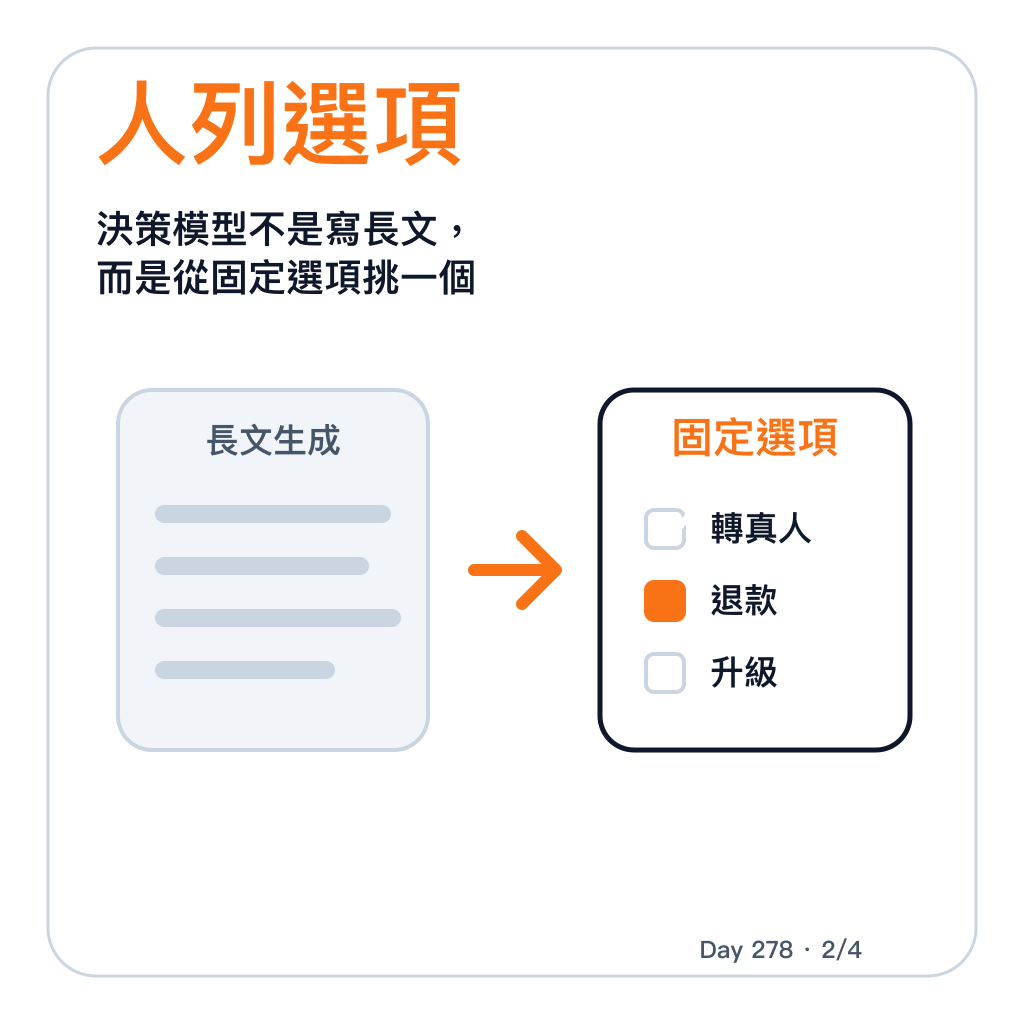
Day 264 我說過,Jev 的本質不是聊天模型,也不是生成模型。它是一個分類器:你把選項先列好,它幫你挑一個。
那時候它有趣,是因為大家還在拿 ChatGPT、Claude 這種會寫長文的模型,去做「客訴該轉哪一組」、「發票狀態是哪一種」這種只有幾個選項的題目。
Jev 說:這件事不用大模型,專門做決策就好。
現在 OpenAI 也說了同一件事。
OpenAI 把這項能力做成 API
OpenAI 在 DevDay 2026 recap 裡,把 Decisions API 描述成:用 Luna 專門回答一組由使用者預先定義的問題,而且答案是有限、預先定義好的。
用途也很直接:分類內容、把請求分流、決定 agent 下一步。
這跟 Jev 的主場幾乎重疊。
差別是,OpenAI 不需要你另外認識一家新服務。它把這項能力放回原本的開發者生態系裡,而且支援文字和圖片當上下文。
| 題目 | 可能答案 |
|---|---|
| 客服訊息要怎麼處理 | 直接回覆/轉真人/退款/升級 |
| 圖片裡的單據狀態 | 缺資料/可報帳/疑似重複/需要人工確認 |
| 這次 agent 下一步 | 查文件/改程式/跑測試/停下來問人 |
這些題目的重點不是「寫一段漂亮文字」;它們需要的是:請你從幾個選項裡挑一個。
如果你本來就在 OpenAI 上做產品,Decisions API 出現後,Jev 的切換成本優勢就會小很多。
價格還不能直接比
我目前找得到 OpenAI 對 GPT-6 Luna 的 API 定價,但沒有看到 Decisions API 自己的專屬價格。
GPT-6 Luna 的模型頁寫的是:輸入每 100 萬 token $0.10,快取輸入 $0.01,輸出 $0.50。它也支援圖片輸入。
但 Decisions API 會不會照 Luna token 計價、會不會另外收、預覽期間怎麼開放,官方公開頁面沒有另外列出價格。
所以我不寫「Jev 被 OpenAI 打死了」。更精準的說法是:Jev 把問題講清楚之後,大廠開始把同一種能力整合進自己的平台。
Cloudflare Clef 也進場了
Clef 放在 Hugging Face 上,Apache-2.0 授權,模型權重可以下載。它不做自由生成文字,主場是專門做決策的多模態模型:可以看文字、JSON 狀態、圖片、影片畫面,再輸出每個答案的可能性分數。問題型態包含:
| 類型 | 意思 |
|---|---|
choice |
從幾個選項裡挑一個 |
score |
給一個分數 |
noul |
回答是/否 |
這組題型跟 Day 264 寫 Jev 時幾乎一樣:是非題、選擇題、評分題。
我還沒有拿 Clef 跟 Jev 跑同一份題目,所以不能說它比較準,也不能說它比較便宜。這篇只能先說:替代方案已經出現了。
光是 Cloudflare 把這類模型的權重公開,就足夠說明一件事:不只 TypeSafe 一家在押寶決策模型。
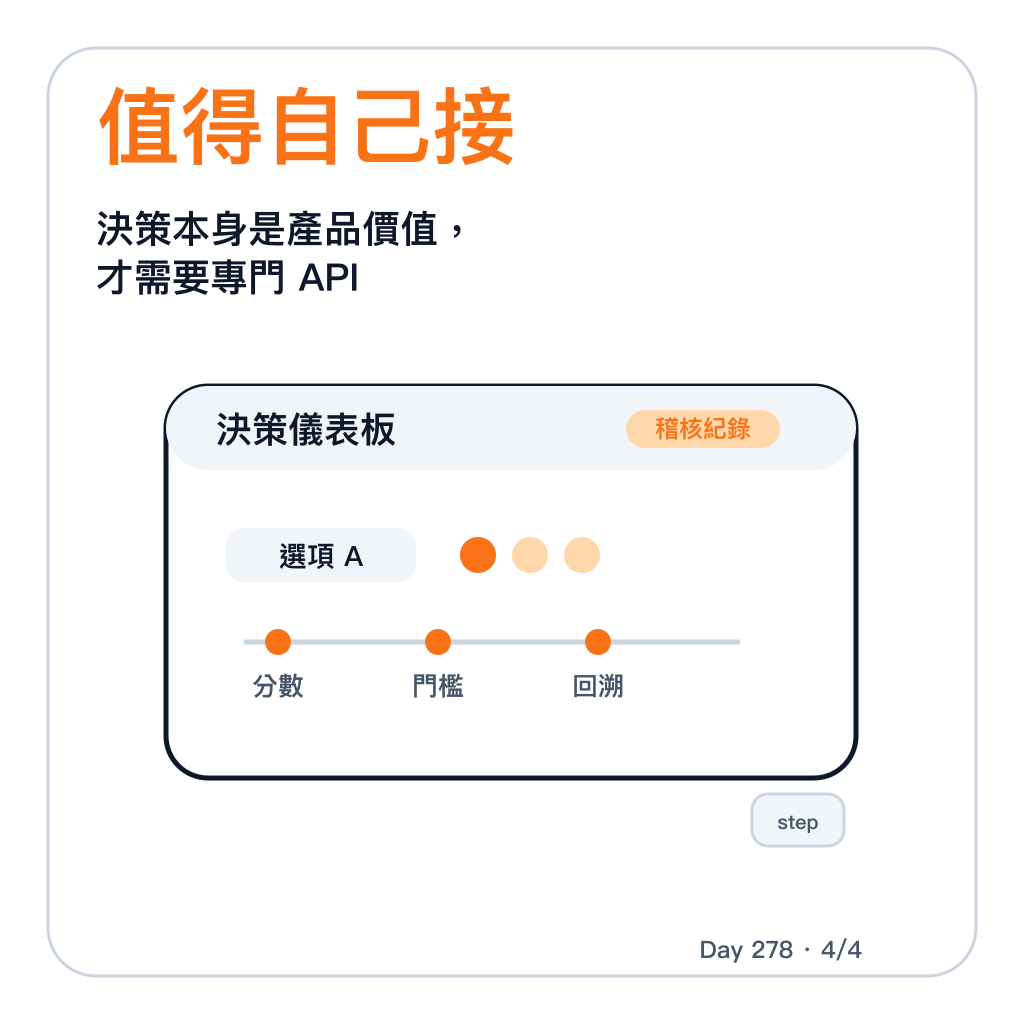
產品本身是決策系統,我會認真考慮自己接
像這幾種場景:
- 每天有大量重複判斷,而且答案選項固定
- 每個判斷都需要留下機率、分數或稽核紀錄
- 錯誤成本夠高,所以你要自己控制資料格式、判斷門檻和備案
- 決策本身就是產品價值,不只是 agent 內部的小步驟
客服分流、單據審核、交易風險、資安告警分級,都是比較合理的例子。
反過來,如果只是讓 coding agent 判斷要不要繼續跑測試,我不會想另外多接一層服務。
這件事應該由 agent 平台自己吃掉。
這種能力不該每次都丟給開發者接
Day 264 的結論是:分類值得有一個專門的模型來做,但最好是 ChatGPT、Claude 自己把它包進去。
現在我還是這樣看。
如果我在用 Codex 或 Claude Code 寫程式,它常常會碰到這種題目:
- 這個錯誤要先查文件、看 log,還是直接改測試?
- 這個 reviewer 留言是 bug、風格問題,還是可以不改?
- 這一輪工作要繼續跑測試、停下來問人,還是切成另一個 task?
這些判斷很適合「挑一個」模型。
但我不想自己另外接 Decisions API,再把 Claude Code 的狀態整理成固定資料格式,送出去拿答案,再把答案餵回工作流程。
如果 agent 本來就有上下文,它應該自己知道什麼時候要改用成本較低、速度較快的固定選項模型。
使用者要的是工作繼續往前,多認識一個 API 沒有幫助。
如果你對這類討論有興趣,歡迎來週二的 AI 小聚一起聊。
所以我預期,未來這類能力會直接被包含在主流 LLM 裡面,用來加快速度。
只有特殊場景,才有必要另外串 API。
Jev 可能沒有死,但它最有價值的核心概念,正逐漸被各平台採用。
Day 264 什麼是 Jev?為什麼我覺得它過譽了?實測數據分享:https://www.dawsonwang.com/day/264 OpenAI DevDay 2026 recap:https://openai.com/index/devday-2026-recap/ OpenAI GPT-6 Luna 模型頁:https://developers.openai.com/api/docs/models/gpt-6-luna OpenAI API pricing:https://developers.openai.com/api/docs/pricing?tab=suite Cloudflare Clef:https://huggingface.co/Cloudflare/clef TypeSafe status:https://status.typesafe.ai/ TypeSafe API docs:https://api.typesafe.ai/redoc TypeSafe Jev announcement:https://typesafe.ai/blog/introducing-system-one-models-and-jev